OSDI'10: Meta Haystack paper
Meta 在 2010 年发布了 Haystack 的论文,在 2014 年发布了 F4 的论文,21 年发布了 Tectonic 的论文,然后 23 年发了 Tectonic-shift 的论文。准确的说发表年份比上线年份是晚点的。
Haystack
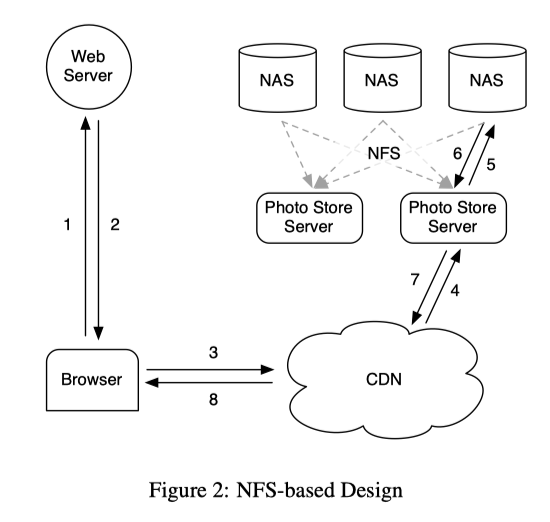
图片数据之前在 HDD NAS 上,通过 NFS 访问。一次请求对应递归目录查找 -> inode 读取 -> 读数据。据论文说「目录规模过大时曾超过十次磁盘操作,缩小目录后一般仍需三次」,然后本质这里已经是冷存了,因为热存在 CDN 上,所以本身访问会有随机性。这里的瓶颈在 HDD IOPS 上(看过上一篇博客就会很清楚)。之前的架构如下图:
有 Haystack 之后:
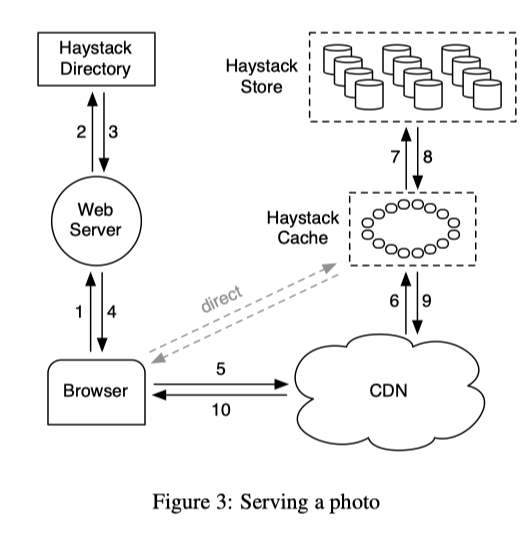
这里论文的一些设计基础我罗列一下:
- 简单(这个我觉得在任何时代都很重要):在生产环境中,一套易于实现、易于维护的设计,其价值再怎么强调都不为过。由于 Haystack 是新系统、缺少多年的生产级检验,我们格外注重保持其简单。正是这种简单性,让我们得以在数月而非数年之内构建并部署出一套可运行的系统。
- Metadata 的路径开销:「在我们基于 NAS 的方案中,一张照片对应一个文件,每个文件至少需要一个 inode,而一个 inode 有数百字节之大。在这种方案下备足主存并不划算。」
- 文件层「Haystack」(这个是本篇文章里面比较被普及的部分了,但我事后看来感觉只看这点会形象对这个论文核心的理解):把多张照片存进同一个文件,因而维护的是非常大的文件
- 元数据切分(我觉得这点其实比较核心,像 Mantle 这样的系统也是借助这点,这点其实很简单,但正是简单才有 insight):应用元数据(application metadata)指构造 URL 所需的信息,浏览器凭此 URL 取回照片;文件系统元数据(filesystem metadata)则指一台主机取回其磁盘上照片所必需的数据。论文有个核心是,把这里元数据切小,把 app metadata 和 filesystem metadata 切开,然后让 filesystem metadata 能缓存在内存中,然后让存储节点内存能 serve 更多的 items。
- Workload: 认为在 CDN 之后,Haystack 缓存数据本身不太经济,因为过了 CDN 一层,非新写入数据再 cachehit概率相对低,只有新写入的数据相对比较温热,这里再次 Haystack cache 可以缓存新写入的数据
这里其实对用户而言,提供了一个 Object Storage 的抽象(论文后面也提了 Object,当然我们今天提到 Object Storage 可能本质类似提 S3 了 ),给 http://⟨CDN⟩/⟨Cache⟩/⟨Machine id⟩/⟨Logical volume, Photo⟩ 这样的 url。
架构
- Directory 是 Haystack 的一个比较粗的「应用元数据」层
- 决定请求应该走 CDN 还是 cache,并对真实打到 Haystack 的请求在各个存储节点 / Logical Volume 做 Load balance。我理解在这篇论文里面,它 Aware 一个 Key 具体分布在的 Logical Volume,同时做一个冷热切分和存储级别 Volume 管理。感觉本身它会需要是一个能 Scale 的库了
- 管理机器 / Volume 的 RO / RW 状态
- 这里逻辑卷对应一个 K 副本的物理状态,这个3副本的状态分布会进 Directory,故障机器的数据丢失后,会移除对应映射,新机器上线后再补充
- 把数据存放在一个带复制的数据库中
- 问题1:这里我们知道,Directory 决定把数据存在哪个逻辑卷,但是我们会有一个写数据 - 发布的流程,然后还会有写失败。比如 3 副本写失败,这块本质问题是 (1) 你没法保证写成功 (2) 你写到一半来了个读者,你告诉它能读,但如果写真的失败了怎么走(如果去这个 volume 读,发现 mdt 有,说明写成功了,没有等于读不到或许也是可以的;或者可以走一个写数据 — 发布的流程。感觉这里疑似往简单做了)。我个人感觉这个论文 Directory 似乎没有做这种发布的流程,只是做了一个「这个 key 会在哪里」,但没有写这些数据何时可见,并决定了一个条目应该去那个 Logical Volume
- 问题2:如果问题1 是成立的,意思是这个条目是否存在交给 HDD 存储 Volume 决定,这里是一个2层的映射。同时这里的多副本之间,要么在3副本之间做一层 2PC / Consensus,如果选到的写成功就能读到,否则就读不到;要么是有个 Publish 路径。不然这个地方多副本之间的语义也很难拿到一个一致的结果?
- SeaweedFS Filer 上传路径先完成 chunk 上传,再保存路径到 chunk 的引用。这使正常路径的元数据发布晚于数据写,感觉虽然有 trade-off,但是一致性语义还是更清晰的,就把这里发布和一致性写的可见交给 Filer 这么一层了
- Cache
- 一个分布式哈希表
- 照片在上传后不久被访问得最频繁;而对于我们的工作负载,文件系统在「只读」或「只写」时通常表现更好,读写混做时则不然(见 4.1 节)。因此,若没有 Cache,可写的 Store 机器将承受最多的读取。
- 这里没有详细讨论 Cache 的实现,不过感觉也不重要,可能当成一个 Blob Key-Value KV 就行。
- Store 节点上有 Volume
- 对外提供的逻辑是
/hay/haystack_<逻辑卷 id>上的 key - Haystack paper 说它这里用单机 RAID6 256KiB 为条带来写入
- 按照 100G 之类的配置大小切物理 Volume,存储成 xfs 上的文件。
- 这里认为 XFS Extent 的形式对存储大文件很友好,方便这些东西 load in memory;然后 preallocation 效果比较好
- 逻辑 Volume 是上层的概念,这里应该选 3副本 写入,然后这些机器决定怎么对应到物理 Volume 上
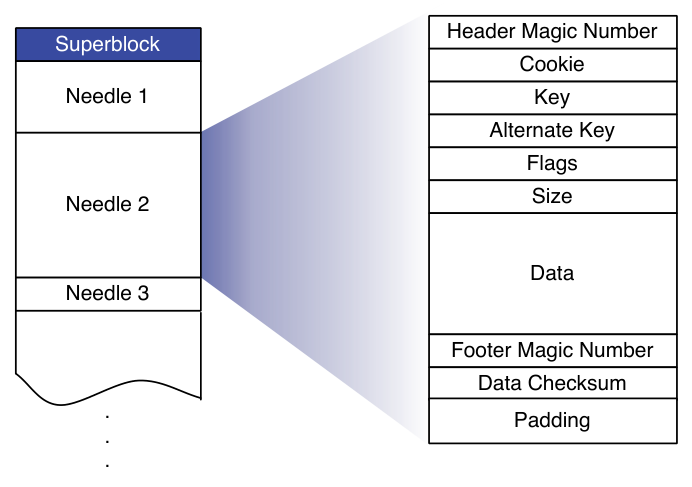
- 每张图片在 Volume 内被存储为下面的 Needle 的形式,然后全部缓存
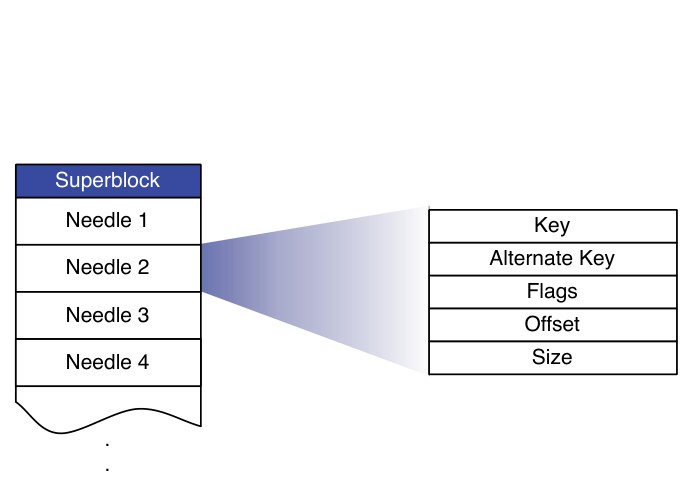
(key, alternate key)在内存中。这个感觉很 adhoc,论文描述「出于历史原因,照片的 id 对应「键」,而其类型(type)用作「备用键」。上传时,Web 服务器把每张照片缩放为四种不同尺寸(即类型),并把它们存为各自独立的 needle,但共用同一个键。这些 needle 之间的关键区别在于备用键字段(即图片尺寸),按尺寸从大到小依次可以是 ‘n’、’a’、’s’ 或 ‘t’。」 - offset=0 表示删, 我不太清楚他这里为什么是直接标记 offset =0 而不是多 Log 一条 offset = 0 的 Needle,我个人其实 prefer 后者一点
- 这里额外的优化是一个图片 4个 alternate key,可以直接丢一起,本质相当于又压缩了一次,「它们共用同一个键(64 位)、备用键各不相同(32 位),因而数据大小也各不相同(16 位)。除了这 32 字节之外,由于哈希表等开销,Haystack 每张图像还要消耗约 2 字节,于是同一张图像缩放得到的四张照片合计为 40 字节」
- 我们假设一块盘 24TiB,这里按照这个 in memory format, 如果平均 256K 一组图片,论文写每组四尺寸 key 合起来 40B,不考虑内存索引结构的装填因子需要 3.75GiB 左右的内存。感觉插满 60块 HDD ,这里会到接近 230GiB 内存,倒也不是不能接受。
- 存储 Index File 来类似写的 Checkpoint,便于恢复 in memory index。这里可以可以从这个索引推出一个推论,本质上 Volume 内的 Metadata 是 HDD 上的 Needle 决定的,in memory index 是这些 Needle Log Replay 出来的(删除略微在这个框架外,是直接更新 Needle 的)。
- 这里可以 Compact,这里设计意图应该是重写:「删除的分布规律与照片浏览类似:越新的照片越可能被删除。在一年的时间跨度内,约有 25% 的照片会被删除」。但是回顾之前的物理 Volume 和逻辑 Volume,这里感觉需要 Dir 层决定一些调度策略,然后决定单机还是分布式去处理 Volume,论文没有提到这里是怎么决策的,我感觉我这点倒是蛮好奇的。
- 对外提供的逻辑是
总结
Haystack 提出了一些比较好的设计,比如元数据的抽象切分(Dir 和单机元数据),同时定义了一些比较简单的语义,论文作者认为系统要简单,我觉得这是很对的。但即使这样,它有个可以推导出的设计 Point 是以HDD 为核心,关于分布式的部分描述非常语焉不详,可见性之类的语义写的不太充分,看不出来作者这一块的语义保障和取舍。可能直接看 SeaweedFS 的一些设计,虽然没有这么简洁,但是会完善一些。